pytest-csv-params: Renovierung und neue Features für Version 2
Vor vielen Jahren, als ich mich noch intensiv mit »Data-Driven Testing« beschäftigt habe, entstand dieses Plugin. Es erreichte schnell einen stabilen Status und wurde nur noch gelegentlich angefasst, wenn es darum ging, Dependencies zu aktualisieren oder die eigene Funktion gegen neue Python- und Pytest-Versionen zu verproben.
Was ist pytest-csv-params?
pytest-csv-params ist ein Pytest1-Plugin, welches es ermöglicht, Testfälle mit Daten aus einer CSV-Datei
zu parametrisieren. Ziel ist, einen einzelnen Testfall mit einer Vielzahl an Datenkonstellationen zu verproben.
Damit sind Testdaten und Testlogik strikt voneinander getrennt und können unabhängig voneinander gepflegt und weiterentwickelt werden.
Außerdem sind CSV-Dateien eine einfache Möglichkeit, um Anforderern die Pflege von Testdaten und Datenkonstellationen zu überlassen, ohne dass sie dazu selbst Python-Code schreiben müssen.
Ein einfaches Beispiel zum Verständnis
Gegeben ist dieser Test:
1def test_addition(a: int, b: int, expected_result: int):
2  assert sum([a, b]) == expected_result
Dazu gibt es diese Testdaten in Form einer CSV-Datei example.csv:
1test_case_id,a,b,expected_result
2TCID01,1,1,2
3TCID02,1,2,3
4TCID03,2,4,6
Mit dem Plugin lässt sich der Test nun so darstellen:
 1from pytest_csv_params.decorator import csv_params
 2
 3@csv_params(
 4    data_file="example.csv",
 5    id_col="test_case_id",
 6    data_casts={
 7        "a": int,
 8        "b": int,
 9        "expected_result": int,
10    },
11)
12def test_addition(a: int, b: int, expected_result: int):
13  assert sum([a, b]) == expected_result
Nun wird der Test test_addition beim Lauf mit jedem Testfall aus der example.csv durchgeführt, also insgesamt
drei Mal.
Detaillierte Informationen gibt es hier:
Nutzerfeedback holt das Projekt aus dem Dornröschenschlaf
Irgendwann erschien ein aktiver Nutzer des Plugins auf der Bildfläche und hatte einige recht konkrete Feature-Wünsche. Teilweise waren sie leicht umzusetzen, teilweise kollidierten sie mit grundsätzlichen Architektur-Entscheidungen, die ich vor vielen Monden getroffen hatte. Es lief alles auf ein grundsätzliches Überdenken sicher geglaubter Vorgaben aus – denn die Wünsche hatten Hand und Fuß und würden die Möglichkeiten für einen professionellen Einsatz deutlich erweitern.
Zudem hat sich sowohl Python als auch Pytest in der Zwischenzeit weiterentwickelt, auch die Build-Umgebung auf
poetry-Basis und die Entwicklungsumgebung in Devcontainern war etwas in die Jahre gekommen. So wurde es Zeit, alte
Zöpfe abzuschneiden und sich in Richtung Version 2 aufzumachen.
Neue Features
Seit der ersten stabilen Version 1.0.0 vom 28. August 2022 gab es viele Releases, die nur technischer Natur waren, etwa zur Unterstützung neuer Python- oder Pytest-Versionen. Aber auch ein paar neue Funktionen sind dazugekommen. Hier sind einige exemplarisch aufgelistet, beginnend nach der ersten stabilen Version bis hin zur derzeit aktuellen Version 2.2:
- Testfall-IDs als Parameter verwenden (seit 1.3.0): Es ist jetzt möglich, die Testfall-ID (im obigen Beispiel
TCID01,TCID02,TCID03) als weiteren Parameter für den Test zu benutzen. Die Dokumentation erklärt genauer, wie das geht. - Pytest 9 ist jetzt offiziell unterstützt (seit 2.0.0): Bisher beschränkte sich die Nutzung auf Pytest in der Version 8. Die PoC-Tests waren erfolgreich, und mit minimalen Anpassungen konnte das Plugin für Pytest 9.0.x und 9.1.x freigegeben werden.
- Testfälle überspringen, wenn Testdaten fehlen (seit 2.1.0): Wenn während der Collection-Phase CSV-Dateien
fehlen oder leer sind, bricht der gesamte Lauf ab. Das ist eine der Design-Entscheidungen, die ich zu Beginn
getroffen habe. Nun gibt es jedoch die Möglichkeit, Testfälle überspringen zu lassen, wenn Daten fehlen. Die
Dokumentation beschreibt die Anwendung:
- Testfall überspringen, wenn CSV-Datei fehlt:
- Globale Einstellung: Command Line Argument
--csv-params-skip-missing - Per-Test-Konfiguration im Decorator: Parameter
skip_when_missing_csv_file
- Globale Einstellung: Command Line Argument
- Testfall überspringen, wenn CSV-Datei leer:
- Globale Einstellung: Command Line Argument
--csv-params-skip-empty - Per-Test-Konfiguration im Decorator: Parameter
skip_when_empty_csv_file
- Globale Einstellung: Command Line Argument
- Testfall überspringen, wenn CSV-Datei fehlt:
- Testdaten als Dictionary statt als einzelne Testmethodenargumente (seit 2.2.0): Wenn man viele Spalten in der
CSV-Datei hat, wird die Definition einer Testfunktion schnell unübersichtlich. Dann kann es von Vorteil sein, wenn
man statt einer Vielzahl von Argumenten ein einzelnes Dictionary hat, in dem sich alle Daten für den jeweiligen Test
wiederfinden. Realisiert wird das mit dem
Decorator-Parameter
parameters_as_dictionary.
Ein detailliertes Changelog findet sich in der Dokumentation.
Neues Entwicklungs- und Buildsystem
Jahrelang war ich ein großer Fan von poetry2 und nutze es auch weiterhin in größeren Projekten. Mein
Spieltrieb hat mich vor einigen Monaten jedoch uv3 ausprobieren lassen. Zugegebenermaßen: Es hat mich nicht
direkt überzeugt, hatte ich doch mit poetry sehr gute Erfahrungen gemacht und anfangs kaum zusätzlichen Nutzen
in uv gesehen. Das änderte sich schließlich, als ich mal wieder in der pyenv-Hölle gefangen war und versucht
habe, irgendwie meine tox-Tests sauber zu bekommen.
Der Umstieg war denkbar einfach. migrate-to-uv4 hat die wesentlichen Anpassungen an der
pyproject.toml vorgenommen und schon war der erste Build erledigt. Nach und nach wurden weitere Details ergänzt,
wie beispielsweise eine feinere Trennung der Dependency-Gruppen. Lediglich der Umbau der Jenkins-basierten Pipeline
war etwas aufwändiger, da sich mit dem Umstieg auf uv das gesamte Testkonzept für Multi-Python-Version-Tests
verändert hat.
Das Handling der verschiedenen Python-Versionen mit uv ist für ein so kleines Projekt so einfach, dass das
Devcontainer-Setup, das ich bisher verwendet habe, nun eine zusätzliche Komplexitätsebene bedeutet, welche den
nun sehr geringen Nutzen nicht mehr rechtfertigt. Daher ist die Devcontainer-Konfiguration (im Verzeichnis
.devcontainer) ersatzlos entfallen.
Moderne mehrstufige Pipeline
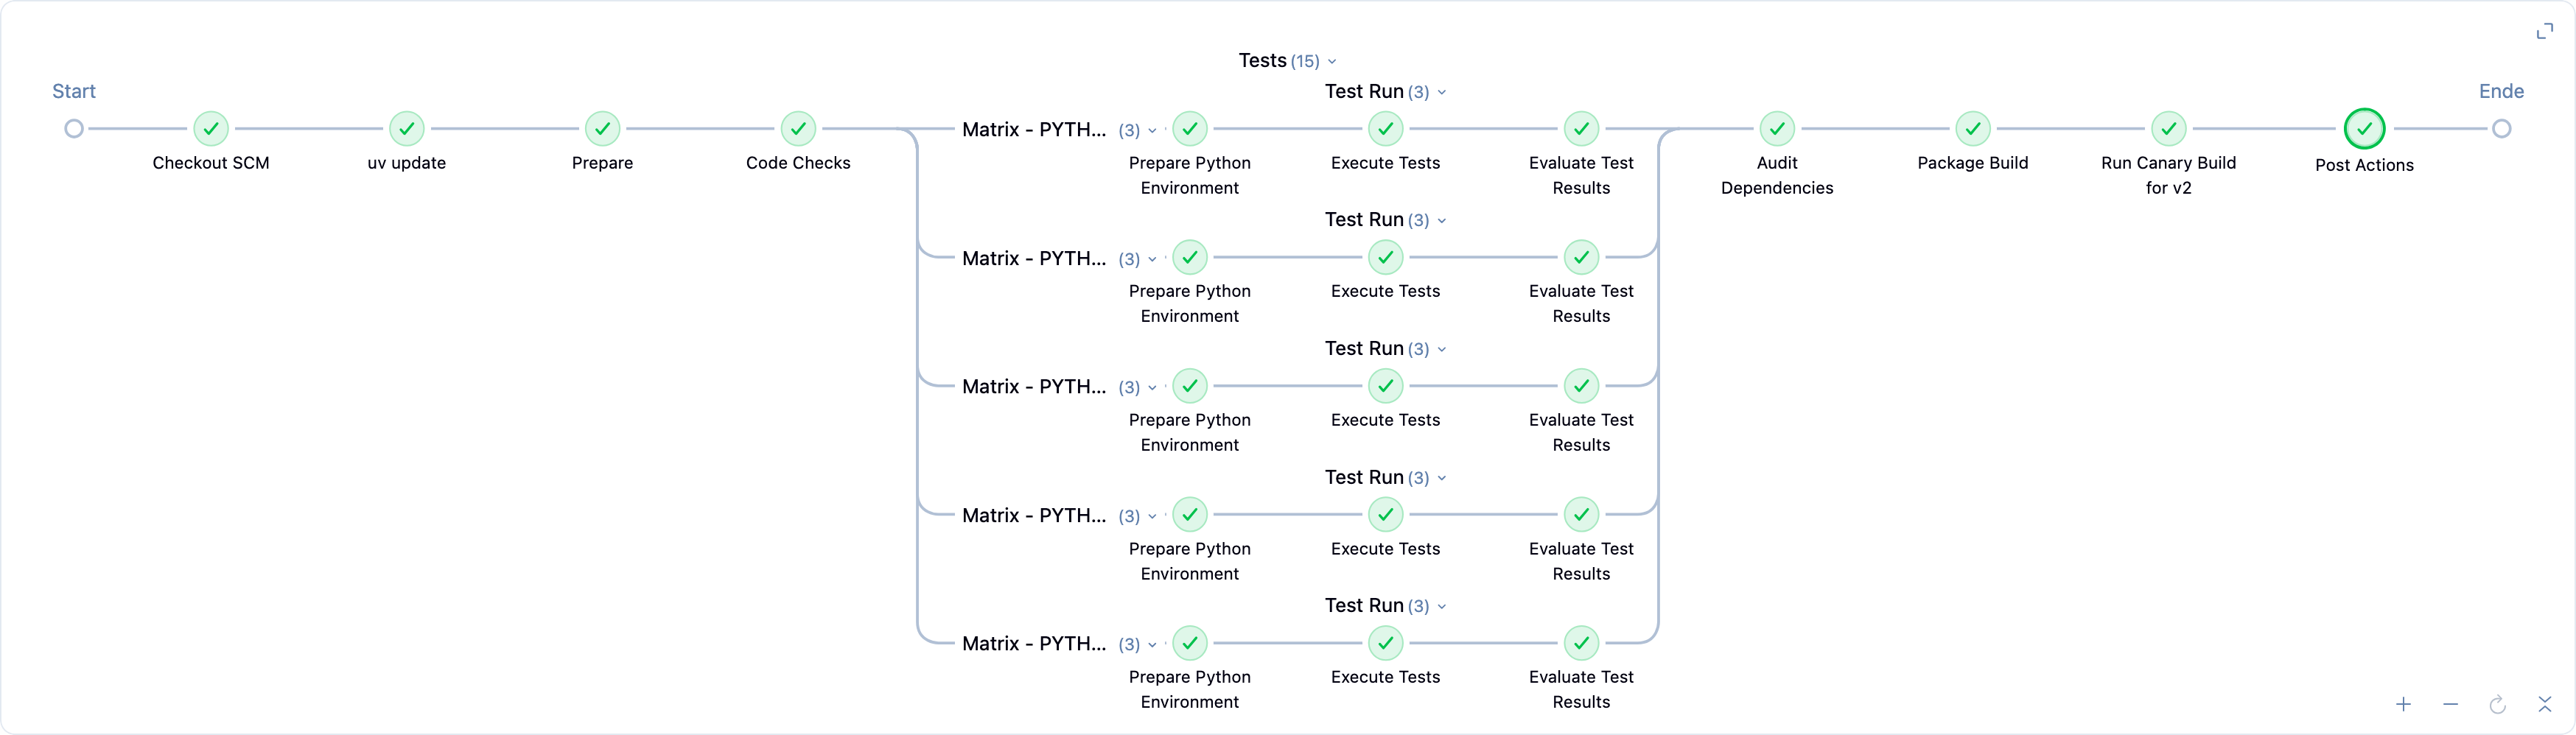
Der eigentliche Build und Test
Ich baue noch sehr klassisch meine Software-Pakete mit Jenkins. Die jeweilige Pipeline-Konfiguration ist Bestandteil
des Softwarequellcodes und liegt im Verzeichnis .ci, meist als Jenkinsfile. Dank uv lässt sich nun mit einer
einfachen Matrix der Test des Codes mit allen unterstützten Python-Minor-Releases durchführen (siehe
.ci/Jenkinsfile in pytest-csv-params/v2.2.3 ).
Der Kanarienvogel
Eine echte Neuerung versteckt sich hinter der Stage Run Canary Build for v2: Denn hier wird eine neue Pipeline
gestartet, die das frisch gebaute und getestete Paket in Kombination mit allen unterstützten Python- und
Pytest-Versionen installiert und einige Smoke-Tests durchführt. So kann ich schnell erkennen, ob es zu Problemen kommt,
wenn Paketversionen zum Einsatz kommen, die gerade nicht in meiner Entwicklungsumgebung vorliegen (siehe
.ci/Jenkinsfile in pytest-csv-params/v2 ):
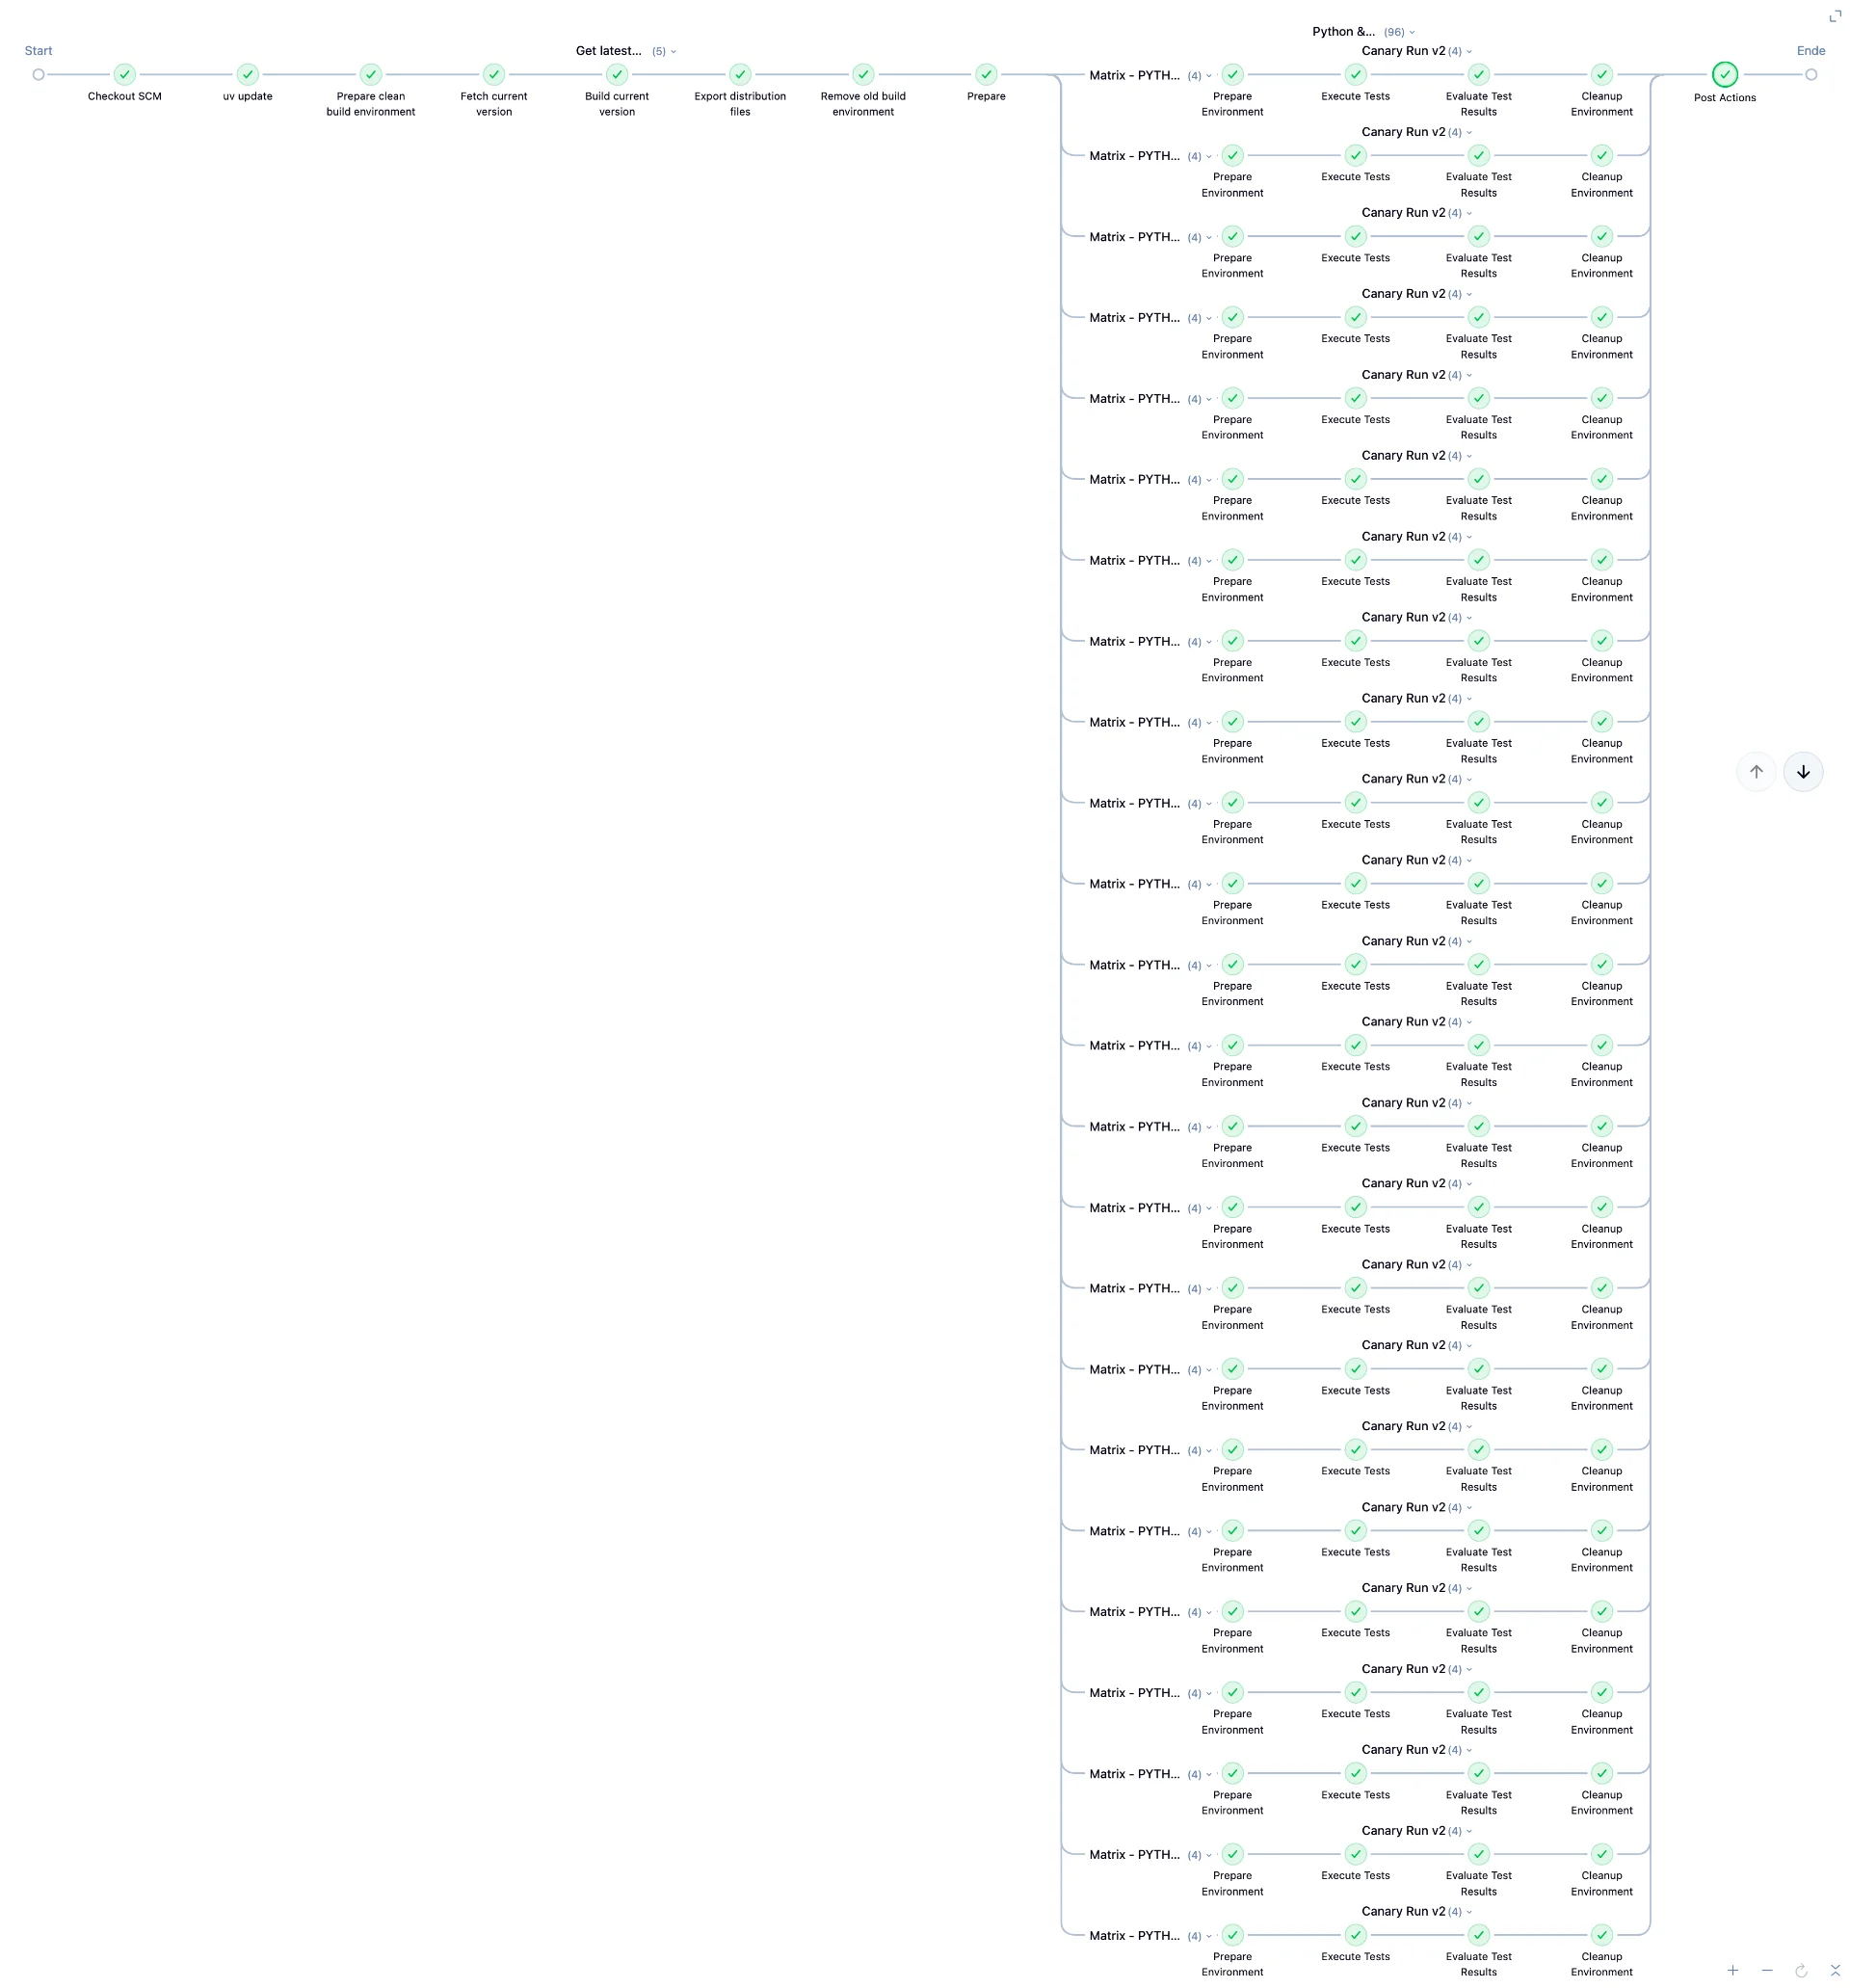
Die Smoke-Tests (siehe
tests/ in pytest-csv-params_canary/v2 )
wirken trivial, aber sie geben mir nach wenigen Sekunden wertvolles Feedback. Wie der Kanarienvogel in der Mine.
Installation und Quellen
Das Plugin pytest-csv-params kann wie jedes andere Paket installiert werden, da es über PyPI verfügbar ist (siehe auch:
Installations-Dokumentation ):
1# pip
2pip install pytest-csv-params
3
4# uv
5uv add pytest-csv-params
6
7# poetry
8poetry add pytest-csv-params
- Quellcode, Issues, etc.: git.codebau.dev/pytest-plugins/pytest-csv-params
- Dokumentation: docs.codebau.dev/pytest-plugins/pytest-csv-params/
pytest-csv-paramsim Python Package Index (PyPI): pypi.org/project/pytest-csv-params/pytest-csv-paramsim Codebau Package Index: git.codebau.dev/pytest-plugins/-/packages/pypi/pytest-csv-params/
Was kommt als Nächstes?
Ich habe einige Ideen für neue Features, die ich aber noch nicht komplett durchdacht habe. Vielleicht dauert es wieder Jahre bis zum nächsten Major Release. Zwischendurch gehe ich vielleicht nochmal an die Dokumentation. Sie ist zwar weitestgehend aktuell, kann aber sicherlich optisch ansprechender gebaut werden.
Glücklicherweise ist die gesamte Pipeline jetzt so aufgebaut, dass ich schneller als bisher auf neue Python- und Pytest-Versionen reagieren und entsprechende Releases erstellen kann.
Spätestens mit der Version 3 wird Pytest <9 und Python <3.11 nicht mehr unterstützt. Ich werde neue Features, die mit älteren Python- und Pytest-Versionen laufen sollten, sofern der Aufwand vertretbar ist und keine Breaking Changes auftreten, in die Version 2 backporten.
Eine entsprechende »Deprecation Notice« findet sich bereits an allen aktuellen Versionen im Changelog.
Dieser Artikel wurde von einem Menschen geschrieben, anschließend mit Hilfe von KI korrigiert und teilweise umformuliert.
KI hat keinerlei Inhalte selbst erzeugt oder Fakten beigetragen.
-
Pytest ist ein sehr bekanntes und weit verbreitetes Test-Framework für Python. Siehe docs.pytest.org/en/stable/ . ↩︎
-
Poetry ist ein Python-Packaging- und Dependency-Management-Tool. Siehe python-poetry.org ↩︎
-
UV ist, ähnlich wie Poetry, auch ein Python-Packaging- und Dependency-Management-Tool, welches jedoch noch weitere Funktionen zur Arbeit an Python-Projekten unterstützt. Siehe docs.astral.sh/uv/ . ↩︎
-
migrate-to-uvist ein Python-Paket, welches die Fleißarbeit bei der Migration despoetry-Projekts nachuvübernommen hat. Siehe osprey-oss.github.io/migrate-to-uv/ ↩︎
Entwicklung Python Testing
Zuletzt geändert: 2026-10-08 14:13:54